%run test_riverswim.pyCS234 Assignment 1:强化学习基础
这是 Stanford CS234 Reinforcement Learning 的 Assignment 1,整理强化学习中的核心概念、数学推导与算法实践。内容涵盖有效时域(effective horizon)对最优策略的影响、奖励投机(reward hacking)、贝尔曼算子(Bellman operator)的性质与性能界,以及 RiverSwim 环境中的策略分析与数值实验。全篇 writeup 按照原作业题号展开,结合理论推导、具体示例和代码计算,重点理解不同问题背后的强化学习原理。
RiverSwim 部分的数值结果基于 riverswim.py,实现了值迭代(Value Iteration, VI)和策略迭代(Policy Iteration, PI)。测试文件是 test_riverswim.py,可通过运行 test_riverswim.py 来验证算法的正确性。
1. 有效时域的影响 (8 pts)
考虑一个为商店管理库存的智能体,该问题被建模为一个马尔可夫决策过程(MDP)。库存水平 \(s\) 指的是当前的存货数量(取值范围为 0 到 10,包含边界值)。在任何时刻,智能体有两种可选动作:出售(若条件允许,库存减少 1)或购入(若条件允许,库存增加 1)。
- 若 \(s>0\) 且智能体执行卖出操作,则获得 \(+1\) 奖励,库存水平变为 \(s−1\)。
- 若 \(s=0\) 且智能体执行卖出操作,则不发生任何变化。
- 若 \(s<9\) 且智能体执行买入操作,则不获得奖励,库存水平变为 \(s+1\)。
- 店主希望在一天结束时库存处于满载状态。因此若库存水平达到最大值 \(s=10\),智能体将获得 \(+100\) 奖励。
- \(s=10\) 是一个终止状态,一旦达到该状态,问题即告结束。
奖励函数,记作 \(r(s,a,s')\),可简要概括如下:
- 当 \(s>0\) 时,\(r(s,\text{sell},s-1)=1\);且 \(r(0,\text{sell},0)=0\);
- 当 \(s<9\) 时,\(r(s,\text{buy},s+1)=0\);且 \(r(9,\text{buy},10)=100\)。
最后这一条件表明,从 \(s=9\) 转移到 \(s=10\)(库存满载)会获得 \(+100\) 的奖励。
假设每日开始时的库存水平始终为 \(s=3\)。我们将探讨当调整该问题的有限时域 \(H\) 时,智能体的最优策略会发生怎样的变化。回想一下,时域 \(H\) 指的是智能体在回合结束前(无论是否已达到终止状态)与 MDP 进行交互的时间步上限。我们将研究当时域 \(H\) 变化时,最优策略(即能获得最高回合奖励的策略)的性质。
以 \(H=4\) 为例。智能体可以进行三次出售操作,状态依次从 \(s=3\) 变为 \(s=2\)、\(s=1\) 和 \(s=0\),每次出售均获得 \(+1\) 的奖励。在第四步时,库存已空,智能体既可选择出售也可选择买入,但无论如何均无奖励。随后,由于时间耗尽,任务结束。
CautionQuestion 1(a) (2 pts)
从初始状态 \(s=3\) 出发,是否可以选取某个 \(H\) 值,使得最优策略在执行过程中既包含买入步骤,也包含卖出步骤?请说明理由。
TipAnswer 1(a)
存在,例如 \(H=9\)。先从 3 卖到 2,获得 1 reward;再连续买入 8 次到达 10,获得 100 reward;总 reward 为 101。直接从 3 买到 10 只得 100 reward。在 9 步内若要到达 10,至多能插入一次卖出,因此上述操作是最优的。
CautionQuestion 1(b) (2 pts)
在无限时域折扣模型中,是否存在一个固定的 \(\gamma\in [0, 1)\),使得从状态 \(s=3\) 出发的最优策略永远不会将库存完全补满?你无需给出具体数值,只需说明你的理由即可。
TipAnswer 1(b)
可以。取足够小的 \(\gamma\) 时,尽快卖出所得到的即时奖励,比至少经过 7 次买入后才可能得到的 100 更有价值。从低库存出发,最优决策可以反复买入一件再卖出,而不必到达 10。特别地,当 \(\gamma=0\) 时,当前奖励完全决定最优动作,从 \(s=3\) 出发先卖出是最优的,也可以选择之后始终不将库存补满。
CautionQuestion 1(c) (2 pts)
考虑该库存管理马尔可夫决策过程(MDP)的两个版本。第一个版本是具有折扣因子 \(\gamma\) 的无限时域 MDP;第二个版本是时域长度为 \(H\) 的有限时域 MDP,该版本不设折扣因子,且无论是否达到终止状态,过程均在恰好 \(H\) 个时间步后结束。
是否存在某个 \(\gamma\) 的取值,使得无限时域 MDP 的最优策略与时域长度为 \(H\) 的有限时域 MDP 的最优策略相同?如果存在,请给出一组满足该条件的 \(\gamma\) 和 \(H\) 的具体数值示例。
TipAnswer 1(c)
存在。取 \(H=1\) 和 \(\gamma=0\),两个问题都只优化当前一步的奖励:在 \(1\le s\le9\),除 \(s=9\) 应买入以获得 100 reward 以外,其余状态应卖出以获得 1 reward;在 \(s=0\) 两个动作即时奖励均为 0,可使用相同的平局规则。因而两者的最优决策可以完全一致。
CautionQuestion 1(d) (2 pts)
在与 (c) 部分相同的设定下,是否存在一个折扣因子 \(\gamma\),使得对于任意的 \(H\),无限时域 MDP 的最优策略与有限时域 MDP 的最优策略一致?请用一两句话简要说明理由。
TipAnswer 1(d)
不能保证。有限时域的最优策略会随 \(H\) 改变:例如较小的 \(H\) 时可能优先通过卖出来获取即时奖励,而较大的 \(H\) 时有足够时间通过买入到达 \(s=10\) 获得 100。有限时域策略可以依赖剩余步数,而无限时域 MDP 通常采用只依赖当前库存的平稳最优策略,无法逐时刻复现这条决策序列。因此没有一个固定的 \(\gamma\) 能匹配所有不同 \(H\) 下的有限时域最优策略。
2. 奖励投机 (5 pts)
问题 1 展示了即使在奖励函数和动力学模型相同的情况下,不同的时间跨度(horizon)和折扣因子(discount factor)也可能导致截然不同的策略。这可能会引发非预期的奖励黑客行为(reward hacking),即最终生成的策略并不符合人类利益相关者的预期目标。本题要求你思考一个由 Pan et al. (2022) 提出的可能出现奖励黑客行为的例子。
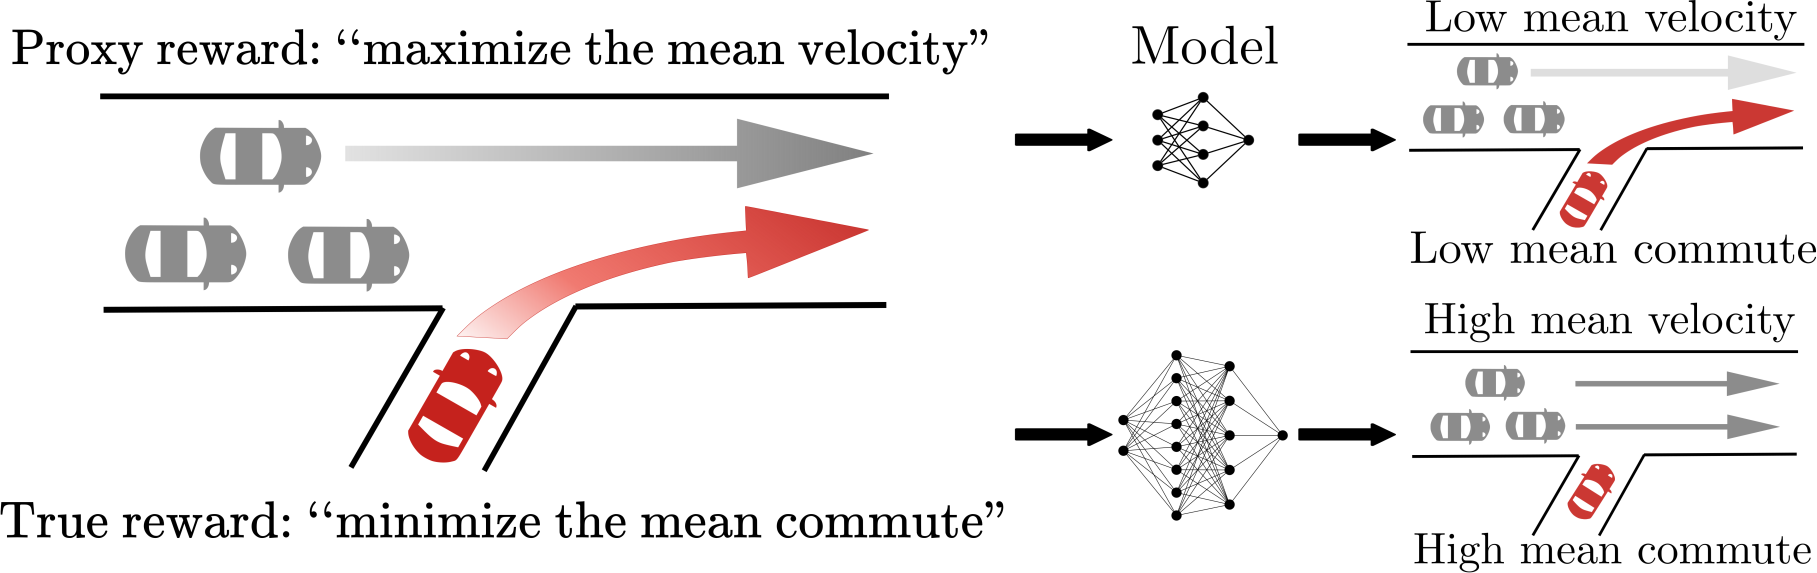
试想一下为自动驾驶汽车设计强化学习系统的场景。其目标是制定决策策略,以最小化所有驾驶员(包括人类驾驶和 AI 驾驶的车辆)的平均通勤时间。直接设定这一奖励函数可能较为复杂(因为它取决于每辆车的目标地点等因素),因此可以采用一种更简单的奖励函数(即代理奖励),即最大化所有车辆的平均速度。
现在考虑这样一种场景:其中只有一辆 AI 驾驶的汽车(图中红色的车),其余多为人类驾驶的汽车(图中灰色的车)。在这种设定下,若采用上述更简单的代理奖励,红色汽车的最优策略将是原地停车,而不驶入高速公路。
CautionQuestion 2(a) (2 pts)
请解释为什么自动驾驶汽车的最优策略是不汇入高速公路。
TipAnswer 2(a)
因为汇入的红车会增加道路拥堵,使许多灰车减速,这些车辆速度下降对总体平均值的影响可能超过红车汇入后自身速度上升的贡献。红车停在公路外便可避免这个拥堵代价,从而提高奖励,尽管它始终没有完成自己的行程。
CautionQuestion 2(b) (3 pts)
请注意,这种行为并不符合真正的奖励函数。请分享一些关于替代奖励函数的想法(即不以最小化换道为目标的函数),这些函数既可能更易于优化,又能避免自动驾驶车辆完全不进入高速公路。本题没有唯一答案,合理的方案均可获得满分。
TipAnswer 2(b)
可以奖励红车沿规划路线的前进距离,并在到达目的地时额外给出一次较大的完成奖励,同时保留对其他车辆拥堵的惩罚。比如令每步奖励为 \(r_t=\Delta d_{\mathrm{AI},t}-\lambda C_t\),到达目的地再加 \(R_{\mathrm{goal}}>0\),其中 \(C_t\) 衡量红车给其他车辆造成的延误。选择足够大的完成奖励并设置合理的安全约束,可以使一直停车失去吸引力。
3. 贝尔曼残差与性能界 (30 pts)
在本题中,我们将研究价值函数以及贝尔曼回溯算子(Bellman backup operator)的性质。
定义:回想一下,价值函数是一个 \(|S|\) 维向量,其中 \(|S|\) 是马尔可夫决策过程(MDP)的状态数量。当我们在这些表达式中使用术语 \(V\) 并将其称为“任意价值函数”时,是指 \(V\) 为一个任意的 \(|S|\) 维向量,它完全不必符合该 MDP 的定义。相比之下,\(V^\pi\) 则是指在 MDP 中由某种策略 \(\pi\) 所产生的价值函数。例如,假设某个 MDP 包含两个状态,且所有即时奖励均为负值。此时,\(V = [1, 1]\) 可以作为一个合法的 \(V\) 取值(尽管该价值函数无法由任何策略 \(\pi\) 产生),但绝不可能出现 \(V^\pi = [1, 1]\) 的情况。对于本题乃至更广泛的强化学习领域而言,区分 \(V\) 与 \(V^\pi\) 至关重要。
贝尔曼算子的性质:在本题的第一部分,我们将探讨课堂上介绍的贝尔曼回溯算子的一些通用且有用的性质。已知贝尔曼回溯算子 \(B\)(定义如下)是一个压缩映射,其不动点为 \(V^*\),即马尔可夫决策过程的最优价值函数。式中各符号含义如下:\(\gamma\) 为折扣因子,且 \(0 \le \gamma < 1\)。在所有部分中,\(\|v\| = \max_s|v(s)|\) 表示向量的无穷范数。
\[ (BV)(s) = \max_a \left( r(s,a) + \gamma \sum_{s' \in S} p(s' \mid s,a)V(s') \right) \]
我们还看到了具有不动点 \(V^\pi\) 的收缩算子 \(B^\pi\),它是以下特定策略的贝尔曼回溯算子:
\[ (B^\pi V)(s) = r(s,\pi(s)) + \gamma \sum_{s' \in S} p(s' \mid s,\pi(s))V(s') \]
在本例中,我们假设 \(\pi\) 是确定性的,但一般情况下未必如此。我们在课上证明了:对于任意两个价值函数 \(V\) 和 \(V'\),有 \(\|BV - BV'\| \le \gamma\|V - V'\|\)。
3.1 贝尔曼算子的性质
CautionQuestion 3(a) (3 pts)
证明类似的不等式 \(\|B^\pi V - B^\pi V'\| \le \gamma\|V - V'\|\) 也成立。
TipAnswer 3(a)
定义无穷范数:
\[ \|V-V'\|_\infty = \max_s|V(s)-V'(s)| \]
和三角不等式:
\[ \left|\sum_{i} a_i\right|\le\sum_i|a_i| \]
对任意状态 \(s\),即时奖励 \(r(s,\pi(s))\) 相互抵消,概率分布 \(p(s'\mid s,\pi(s))\) 非负且和为 1,得到:
\[ \begin{align} |(B^\pi V)(s)-(B^\pi V')(s)| &= \gamma\left|\sum_{s'\in S}p(s'\mid s,\pi(s))(V(s')-V'(s'))\right| \\ &\le \gamma\sum_{s'\in S}p(s'\mid s,\pi(s))|V(s')-V'(s')| \\ &\le \gamma\sum_{s'\in S}p(s'\mid s,\pi(s))\|V-V'\|_\infty \\ &= \gamma\|V-V'\|_\infty \end{align} \]
CautionQuestion 3(b) (3 pts)
证明 \(B^\pi\) 的不动点是唯一的。回想一下,不动点定义为满足 \(V = B^\pi V\) 的 \(V\)。你可以假设不动点存在。提示:考虑使用反证法。
TipAnswer 3(b)
若 \(U\) 和 \(W\) 都是不动点,则由 3(a) 得:
\[ \|U-W\|_\infty=\|B^\pi U-B^\pi W\|_\infty\le\gamma\|U-W\|_\infty \]
由于 \(\gamma<1\),只能有 \(\|U-W\|_\infty=0\),即 \(U=W\)。
CautionQuestion 3(c) (3 pts)
假设 \(V\) 和 \(V'\) 是满足对所有 \(s\) 都有 \(V(s) \le V'(s)\) 的向量。证明对所有 \(s\) 都有 \(B^\pi V(s) \le B^\pi V'(s)\)。注意,所有这些不等式都是逐元素的。
TipAnswer 3(c)
对每个 \(s\),我们有:
\[ (B^\pi V')(s)-(B^\pi V)(s) =\gamma\sum_{s'}p(s'\mid s,\pi(s))(V'(s')-V(s'))\ge 0 \]
因为每项都非负。
所以得到:
\[ B^\pi V(s)\le B^\pi V'(s) \]
3.2 残差与贪心策略的性能
贝尔曼残差:在对价值函数和贝尔曼算子有了直观理解之后,我们现在转而探讨如何提取策略以及这些策略的性能表现。我们可以利用下式从任意价值函数 \(V\) 中提取贪心策略 \(\pi\)。
\[ \pi(s) = \arg\max_a \left[r(s,a )+ \gamma \sum_{s'\in S} p(s'\mid s,a)V(s') \right] \]
了解从任意价值函数中提取贪心策略后的性能表现通常很有帮助。为此,我们引入“贝尔曼残差”这一概念。
定义贝尔曼残差为 \((BV - V)\),并将贝尔曼误差的大小定义为 \(\|BV - V\|\)。
CautionQuestion 3(d) (2 pts)
对于哪个值函数 \(V\),贝尔曼误差的大小 \(\|BV - V\|\) 等于 0?为什么?
TipAnswer 3(d)
只有 \(V=V^*\)。零残差意味着 \(BV=V\),即 \(V\) 是 \(B\) 的不动点。收缩映射的不动点唯一,且它就是最优值函数。
CautionQuestion 3(e) (5 pts)
对任意价值函数 \(V\) 和任意策略 \(\pi\),证明:
\[ \|V-V^\pi\|_\infty\le\frac{\|V-B^\pi V\|_\infty}{1-\gamma}, \qquad \|V-V^*\|_\infty\le\frac{\|V-BV\|_\infty}{1-\gamma} \]
提示:尝试通过插入一个零项来利用三角不等式。
TipAnswer 3(e)
定义三角不等式:
\[ \|a+b\|_\infty \le \|a\|_\infty+\|b\|_\infty \]
利用 \(B^\pi V^\pi=V^\pi\),插入 \(B^\pi V\) 并用三角不等式和 3(a):
\[ \begin{align} \|V-V^\pi\|_\infty &=\|V-B^\pi V +B^\pi V-B^\pi V^\pi\|_\infty \\ &\le\|V-B^\pi V\|_\infty+\|B^\pi V-B^\pi V^\pi\|_\infty \\ &\le\|V-B^\pi V\|_\infty+\gamma\|V-V^\pi\|_\infty \end{align} \]
移项即得第一式。
把 \(B^\pi,V^\pi\) 分别换成 \(B,V^*\),再利用 \(B\) 的收缩性:
\[ \begin{align} \|V-V^*\|_\infty &=\|V-BV +BV-BV^*\|_\infty \\ &\le\|V-BV\|_\infty+\|BV-BV^*\|_\infty \\ &\le\|V-BV\|_\infty+\gamma\|V-V^*\|_\infty \end{align} \]
移项即得第二式。
你在 3(e) 部分证明的结果将有助于证明接下来几个部分中策略性能的界限。给定贝尔曼残差,我们现在将尝试推导出策略性能 \(V^\pi\) 的界限。
CautionQuestion 3(f) (5 pts)
设 \(V\) 为任意价值函数,\(\pi\) 是由 \(V\) 导出的贪心策略。令 \(\varepsilon=\|BV-V\|\) 为 \(V\) 的贝尔曼误差大小。对于任意状态 \(s\),证明以下结论:
\[ V^\pi(s)\ge V^*(s)-\frac{2\varepsilon}{1-\gamma} \]
提示:尝试使用 3(e) 部分的结果。
TipAnswer 3(f)
根据题给条件,我们有:
\[ B^\pi V = BV \]
且 3(e) 同时给出:
\[ \|V-V^\pi\|_\infty\le\frac{\varepsilon}{1-\gamma}, \qquad \|V-V^*\|_\infty\le\frac{\varepsilon}{1-\gamma} \]
我们知道,绝对值误差不可能超过无穷范数误差。因此对任意状态 \(s\),有:
\[ |V^*(s) - V(s)| \le \|V^* - V\|_\infty, \qquad |V(s) - V^\pi(s)| \le \|V - V^\pi\|_\infty \]
因此:
\[ \begin{align} V^*(s)-V^\pi(s) &\le |V^*(s)-V(s)|+|V(s)-V^\pi(s)| \\ &\le \frac{2\varepsilon}{1-\gamma} \end{align} \]
移项得到:
\[ V^\pi(s)\ge V^*(s)-\frac{2\varepsilon}{1-\gamma} \]
CautionQuestion 3(g) (2 pts)
举例说明在哪些实际应用或领域中,对 \(V^\pi(s)\) 求下界会很有用。
TipAnswer 3(g)
在数据中心的任务调度中,可以把 \(V^\pi(s)\) 定义为某个负载状态下的折扣服务收益。即使只能近似计算值函数,策略收益下界仍可用于判断新调度策略是否满足最低服务水平,再决定是否上线。
CautionQuestion 3(h) (2 pts)
假设我们有另一个价值函数 \(V'\) 并提取其贪心策略 \(\pi'\),且满足 \(\|BV'-V'\|=\varepsilon=\|BV-V\|\)。上述下界是否意味着对于任意状态 \(s\) 都有 \(V^\pi(s) = V^{\pi'}(s)\)?
TipAnswer 3(h)
不意味着。相同的残差范数只给两种策略同一个最坏情形下界,没有规定 \(V\) 与 \(V'\) 的误差方向或各状态的贪心动作,因此策略和值函数都可能不同。
再补充一点符号定义:若对于所有状态 \(s\) 均有 \(V(s)\le V'(s)\),则记作 \(V\le V'\)。
如果我们的算法返回的 \(V\) 满足 \(V^*\le V\)(即该值函数优于 MDP 的最优值函数),情况会怎样呢?请注意,\(V\) 可以是任意向量,未必是 MDP 中可达到的值函数,但我们仍希望对由该 \(V\) 导出的策略 \(\pi\) 所对应的性能 \(V^\pi\) 给出界限。我们将证明,若满足此条件,便能获得关于策略性能更紧的界限。
CautionQuestion 3(i) (5 pts)
沿用 3(e) 部分的符号与设定。若 \(V^*\le V\),试证明对于任意状态 \(s\),下式成立:
\[ V^\pi(s) \ge V^*(s) - \frac{\varepsilon}{1-\gamma} \]
其中,\(\varepsilon=\|BV - V\|\),且策略 \(\pi\) 是由 \(V\) 导出的贪心策略。
提示:回想一下,对于任意策略 \(\pi\),均有 \(V^\pi \le V^*\)(为什么?)。
TipAnswer 3(i)
根据题目条件 \(V^*\le V\),以及最优价值函数的定义 \(V^\pi\le V^*\),我们有:
\[ V^\pi(s)\le V^*(s)\le V(s) \]
根据 3(e) 部分的结果,我们可以得到:
\[ \begin{aligned} V^*(s)-V^\pi(s) &\le V(s)-V^\pi(s) \\ &=|V(s)-V^\pi(s)| \\ &\le \|V-V^\pi\|_\infty \\ &\le \frac{\varepsilon}{1-\gamma} \end{aligned} \]
移项得到:
\[ V^\pi(s)\ge V^*(s)-\frac{\varepsilon}{1-\gamma} \]
至于为什么 \(V^\pi \le V^*\)?这是因为 \(V^*\) 是所有策略的最优值函数。因此对于任何策略 \(\pi\),其对应的值函数 \(V^\pi\) 都不可能超过 \(V^*\)。
3.3 可选挑战题
直观理解:理解 3(h) 和 3(i) 结果的一种很有帮助的方式,是基于以下观察:若每个时间步都获得恒定的即时奖励 \(r\),则总的折扣奖励为:
\[ r + \gamma r + \gamma^2 r + \dots = \frac{r}{1-\gamma} \]
因此,上述结果表明,对于一个贝尔曼误差幅度为 \(\varepsilon\) 的状态值函数 \(V\),由此导出的贪婪策略其单步平均奖励与最优策略的差距至多为 \(2\varepsilon\)。这意味着,如果我们开发出一种能减小贝尔曼残差的算法,就能对该算法输出的值函数所导出的策略性能设定界限。这非常有用!
CautionQuestion 3(j) (0 pts)
要证明条件 \(V^*\le V\) 成立并非易事,因为我们往往不知道 MDP 的 \(V^*\)。请证明:若 \(BV \le V\),则 \(V^* \le V\)。注意,这一充分条件更易于验证,且无需预先知道 \(V^*\)。
提示:尝试使用数学归纳法。\(\lim_{n \to \infty} B^n V\) 是什么?
TipAnswer 3(j)
因为贝尔曼算子具有单调性:
\[ BV \le V \]
所以:
\[ \dots\le B^3V \le B^2V \le BV \le V \]
而贝尔曼算子是压缩映射,因此:
\[ \lim_{n \to \infty} B^n V = V^* \]
对两边取极限,得到:
\[ V^* = \lim_{n \to \infty} B^n V \le V \]
CautionQuestion 3(k) (0 pts)
我们可以进一步收紧 3(i) 部分和 3(f) 部分中得到的界。设 \(V\) 为任意值函数,\(\pi\) 是由 \(V\) 导出的贪心策略。令 \(\varepsilon = \|BV - V\|\) 为 \(V\) 的贝尔曼误差大小,请针对任意状态 \(s\) 证明:
\[ V^\pi(s) \geq V^*(s) - \frac{2\gamma\varepsilon}{1-\gamma} \]
此外,若 \(V^* \leq V\),请针对任意状态 \(s\) 证明:
\[ V^\pi(s) \geq V^*(s) - \frac{\gamma\varepsilon}{1-\gamma} \]
TipAnswer 3(k)
设 \(\pi^*\) 是最优策略。利用固定点性质,我们有:
\[ BV^* = V^*, \qquad B^\pi V^\pi = V^\pi \]
由 \(B^\pi V=BV\ge B^{\pi^*}V\),对任意状态有:
\[ \begin{align} V^*-V^\pi &=B^{\pi^*}V^*-B^\pi V^\pi \\ &\le B^{\pi^*}V^*-B^{\pi^*}V+B^\pi V-B^\pi V^\pi \\ &=\gamma P^{\pi^*}(V^*-V)+\gamma P^\pi(V-V^\pi) \end{align} \]
由于 \(P\) 是转移矩阵,根据转移矩阵的性质:
\[ P^\pi \mathbf 1 = \mathbf 1 \]
即每一行的概率之和为 1。
所以对任意向量 \(x\):
\[ P^\pi x \le \|x\|_\infty\mathbf 1 \]
于是:
\[ \begin{aligned} V^*-V^\pi &\le\gamma\|V^*-V\|_\infty\mathbf 1 + \gamma\|V-V^\pi\|_\infty\mathbf 1 \\ &\le\frac{2\gamma\varepsilon}{1-\gamma}\mathbf 1 \end{aligned} \]
因此对每个状态 \(s\):
\[ V^\pi(s)\ge V^*(s)-\frac{2\gamma\varepsilon}{1-\gamma} \]
若 \(V^*\le V\),第一项逐状态非正,只剩第二项:
\[ \begin{align} V^*-V^\pi &\le \gamma\|V-V^\pi\|_\infty\mathbf 1 \\ &\le \frac{\gamma\varepsilon}{1-\gamma}\mathbf 1 \end{align} \]
因此对每个状态 \(s\):
\[ V^\pi(s)\ge V^*(s)-\frac{\gamma\varepsilon}{1-\gamma} \]
4. RiverSwim MDP (25 pts)
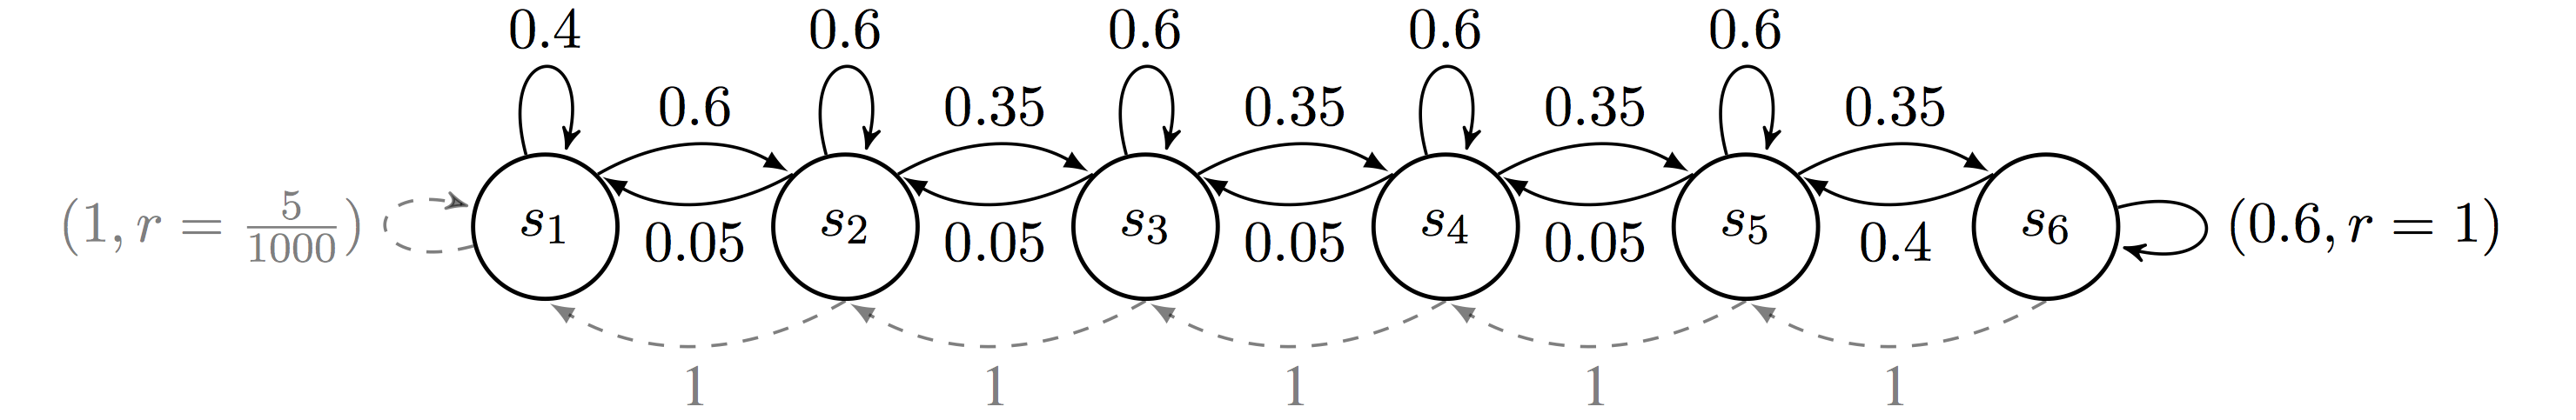
接下来,你将针对 Strehl and Littman (2008) 提出的 RiverSwim 环境(见下图 2)实现值迭代(Value Iteration, VI)和策略迭代(Policy Iteration, PI)。图中虚线箭头和实线箭头分别表示“向左”和“向右”动作对应的状态转移。本次作业使用的是上述模型的一个改进且可定制的版本,其中包含三种不同强度的水流(弱、中、强),这决定了被推回原处或成功向右游动的转移概率。
CautionQuestion 4(a) (4 pts)
请阅读 vi_and_pi.py 并实现 bellman_backup 函数。该函数应返回针对输入的状态-动作对执行一次贝尔曼更新(Bellman backup)所得的值。
bellman_backup.py
    def bellman_backup(
        self, state: int, action: int, V: np.ndarray, gamma: float
    ) -> float:
        r"""Performs a Bellman backup for a given state and action.

        The Bellman backup is defined as:

        .. math::
            Q(s, a) = R(s, a) + \gamma \sum_{s'} T(s, a, s') V(s')

        Args:
            state (int): The current state.
            action (int): The action taken in the current state.
            V (np.ndarray): The value function of shape `(num_states,)`.
            gamma (float): The discount factor.

        Returns:
            Q (float): The updated value for the given state and action.
        """
        assert 0 <= gamma < 1, 'Discount factor must be in [0, 1).'
        return self.R[state, action] + gamma * np.dot(self.T[state, action], V)
CautionQuestion 4(b) (8 pts)
在 vi_and_pi.py 中实现 policy_evaluation、policy_improvement 和 policy_iteration。返回最优价值函数和最优策略。
policy_iteration.py
def policy_evaluation(
        self, policy: np.ndarray, gamma: float, tol: float = 1e-3
    ) -> np.ndarray:
        r"""Perform policy evaluation for a given **deterministic** policy.

        The value function for a policy is defined as:

        .. math::
            V(s) = R(s, \pi(s)) + \gamma \sum_{s'} T(s, \pi(s), s') V(s')

            V(s) = Q(s, \pi(s))

        Args:
            policy (np.ndarray): The policy to evaluate.
            gamma (float): The discount factor.
            tol (float): The tolerance for convergence.

        Returns:
            V (np.ndarray): The value function for the given policy.

        Example:
            >>> env = RiverSwimEnvr(Current.WEAK)
            >>> policy = np.array([Action.RIGHT] * env.num_states)
            >>> V = env.policy_evaluation(policy, gamma=0.9)
        """
        assert 0 <= gamma < 1, 'Discount factor must be in [0, 1).'
        old_V = np.zeros(self.num_states)

        while True:
            new_V = np.array(
                [
                    self.bellman_backup(state, policy[state], old_V, gamma)
                    for state in range(self.num_states)
                ]
            )

            if np.max(np.abs(new_V - old_V)) < tol:
                return new_V

            old_V = new_V

    def policy_improvement(self, V_policy: np.ndarray, gamma: float) -> np.ndarray:
        r"""Compute the improved policy given the value function of the current policy.

        .. math::
            \pi'(s) = \arg\max_a Q(s, a)

        Args:
            V_policy (np.ndarray): The value function of the current policy.
            gamma (float): The discount factor.

        Returns:
            new_policy (np.ndarray): The improved policy.

        Example:
            >>> env = RiverSwimEnvr(Current.WEAK)
            >>> policy = np.array([Action.RIGHT] * env.num_states)
            >>> V_policy = env.policy_evaluation(policy, gamma=0.9)
            >>> new_policy = env.policy_improvement(V_policy, gamma=0.9)
        """
        assert 0 <= gamma < 1, 'Discount factor must be in [0, 1).'
        new_policy = np.zeros(self.num_states, dtype=np.int8)

        for state in range(self.num_states):
            action_values = [
                self.bellman_backup(state, action, V_policy, gamma)
                for action in range(self.num_actions)
            ]
            new_policy[state] = np.argmax(action_values)

        return new_policy

    def policy_iteration(self, gamma: float, tol: float = 1e-3) -> RiverSwimResult:
        r"""Perform policy iteration to find the optimal policy for the RiverSwim MDP.
        The algorithm alternates between policy evaluation and policy improvement until
        convergence.

        Args:
            gamma (float): The discount factor.
            tol (float, default: 1e-3): The tolerance for convergence in policy evaluation.

        Returns:
            result (RiverSwimResult): The optimal policy found by policy iteration.

        Example:
            >>> env = RiverSwimEnvr(Current.WEAK)
            >>> result = env.policy_iteration(gamma=0.9)
        """
        assert 0 <= gamma < 1, 'Discount factor must be in [0, 1).'
        old_policy = np.zeros(self.num_states, dtype=np.int8)

        while True:
            V_policy = self.policy_evaluation(old_policy, gamma, tol)
            new_policy = self.policy_improvement(V_policy, gamma)

            if np.array_equal(new_policy, old_policy):
                break

            old_policy = new_policy

        return RiverSwimResult(policy=new_policy, val_func=V_policy)
CautionQuestion 4(c) (8 pts)
在 vi_and_pi.py 中实现 value_iteration。返回最优价值函数和最优策略。
value_iteration.py
def value_iteration(self, gamma: float, tol: float = 1e-3) -> RiverSwimResult:
        r"""Perform value iteration to find the optimal policy for the RiverSwim MDP.
        The algorithm iteratively updates the value function until convergence, and then
        derives the optimal policy from the final value function.

        .. math::
            Q(s, a) = R(s, a) + \gamma \sum_{s'} T(s, a, s') V(s')

            V(s) = \max_a Q(s, a)

        Args:
            gamma (float): The discount factor.
            tol (float, default: 1e-3): The tolerance for convergence in value iteration.

        Returns:
            result (RiverSwimResult): The optimal policy found by value iteration.

        Example:
            >>> env = RiverSwimEnvr(Current.WEAK)
            >>> result = env.value_iteration(gamma=0.9)
        """
        assert 0 <= gamma < 1, 'Discount factor must be in [0, 1).'
        old_V = np.zeros(self.num_states)

        while True:
            new_V = np.array(
                [
                    max(
                        self.bellman_backup(state, action, old_V, gamma)
                        for action in range(self.num_actions)
                    )
                    for state in range(self.num_states)
                ]
            )

            if np.max(np.abs(new_V - old_V)) < tol:
                old_V = new_V
                break

            old_V = new_V

        # One more policy improvement step to get the optimal policy.
        policy = self.policy_improvement(new_V, gamma)
        return RiverSwimResult(policy=policy, val_func=new_V)
CautionQuestion 4(d) (5 pts)
在弱水流条件下对 RiverSwim 环境运行这两种方法,找出最大的折扣因子(精确到小数点后两位),使得一个从最左侧初始状态(图 2 中的状态 \(s_1\))出发的最优智能体不会逆流而上(即不向右移动)。利用你找到的数值,解释为什么这种行为是合理的。接下来,分别针对中等水流和强水流条件重复上述过程。请从定量和定性两个角度,描述并解释所得最优值及折扣因子的变化情况。
合理性检查:对于折扣因子 \(\gamma=0.99\) 且弱水流的 RiverSwim 环境,当计算容差设为 0.001 时,最左侧状态(图 2 中的 \(s_1\))和最右侧状态(图 2 中的 \(s_6\))的价值分别为 30.328 和 36.859。VI 和 PI 算法得出的价值函数值应与上述数值的偏差在 0.001 以内。你可以利用这一点来验证你的实现。
TipAnswer 4(d)
以 0.01 为步长枚举 \(\gamma\in\{0,0.01,\ldots,0.99\}\),在每种水流下运行策略迭代,并检查初始状态动作,结果如下表。\(V^*(s_1)\) 和 \(V^*(s_6)\) 采用较紧的迭代容差,数值四舍五入至六位小数。
| 水流 | 最大 \(\gamma\) | \(V^*(s_1)\) | \(V^*(s_6)\) |
|---|---|---|---|
| 弱 | 0.66 | 0.014706 | 1.955507 |
| 中 | 0.77 | 0.021739 | 2.317324 |
| 强 | 0.93 | 0.071429 | 3.177108 |
在上述折扣因子下,最优策略在 \(s_1\) 始终选择 LEFT,每一步获得 0.005 的即时奖励。这一行为是合理的,因为向右游需要放弃当前确定的奖励,以换取未来到达 \(s_6\) 后获得更高奖励的机会。当折扣因子较小时,智能体更重视即时奖励,因此倾向于留在 \(s_1\) 并持续选择 LEFT。
随着水流增强,中间状态成功向右移动的概率从 0.31 降低至 0.22,再降低至 0.13,使得到达右端高奖励状态更加困难。因此,智能体只有在折扣因子足够大、更加重视长期收益时,才愿意向右游。这解释了临界折扣因子从弱水流下的 0.66,逐渐增加到强水流下的 0.93。
从定量角度看,三个临界折扣因子对应的 \(V(s_1)\) 和 \(V(s_6)\) 均逐渐增大。但由于不同水流条件对应的折扣因子也不同,价值函数的增加并不意味着更强的水流能够直接带来更高收益。总体而言,水流越强,智能体越难到达右端高奖励状态,因此需要更大的折扣因子才能使向右游成为最优选择。
合理性验证:
....
----------------------------------------------------------------------
Ran 4 tests in 0.038s

OK
References
Osband, Ian, Daniel Russo, and Benjamin Van Roy. 2013. (More) Efficient Reinforcement Learning via Posterior Sampling. https://arxiv.org/abs/1306.0940.
Pan, Alexander, Kush Bhatia, and Jacob Steinhardt. 2022. The Effects of Reward Misspecification: Mapping and Mitigating Misaligned Models. https://arxiv.org/abs/2201.03544.
Strehl, Alexander L., and Michael L. Littman. 2008. “An Analysis of Model-Based Interval Estimation for Markov Decision Processes.” Journal of Computer and System Sciences 74 (8): 1309–31. https://doi.org/https://doi.org/10.1016/j.jcss.2007.08.009.