16.1 从 generate() 到 Inference Engine:为什么大模型推理需要一个系统

前面的章节里,我们已经讨论过 Decoder-only Transformer、自回归生成、KV cache,以及 temperature、top-k、top-p 等生成方法。如果只是让一个模型根据 prompt 生成一段文本,代码看起来并不复杂:
outputs = model.generate(input_ids, max_new_tokens=128)从模型的角度看,这件事确实只是不断预测下一个 token。但是,当模型真正作为在线服务运行时,问题很快就会发生变化。
此时系统面对的不是一个固定输入,而是不断到来的请求:有的 prompt 很短,有的 prompt 很长;有的只生成几个 token,有的可能持续生成几百甚至几千个 token;有的请求刚刚到达,有的已经生成了一半,还有的马上就要结束。与此同时,这些请求还要共享同一组 GPU、同一块显存,以及有限的计算资源。
所以,大模型推理真正需要解决的问题不只是模型如何预测下一个 token,而是:
如何把有限的 GPU compute 和 GPU memory,高效地分配给一组不断变化的 request?
这也是为什么现代大模型推理通常不会直接围绕 model.generate() 组织,而是会在模型外面再构建一层 Inference Engine。这一章不会直接讨论某个具体推理框架的实现,而是先抽象出这类系统普遍面对的问题和常见组件,为后面进一步理解 vLLM 和 SGLang 做准备。
16.1.1 一个 Request 不是一次 Forward
在普通的神经网络推理里,我们很容易把一次请求理解成一次模型调用。例如图像分类模型收到一张图片,执行一次 forward,得到分类结果,这个请求基本就结束了。
LLM 的情况不一样。由于生成是自回归的,一个请求通常需要经历很多轮模型执行。假设某个请求最终生成了 100 个 token,那么它不会只执行一次模型,而是会在系统里持续存在很多个 decoding step。
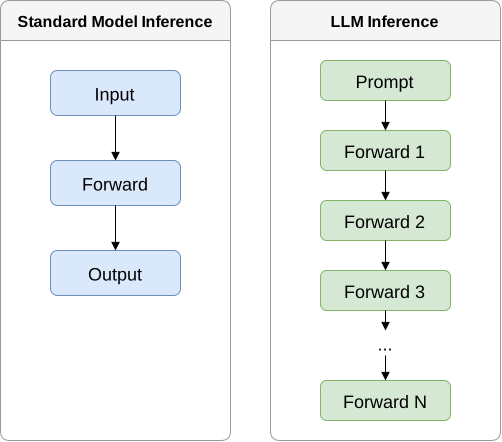
在这段时间里,请求本身不能被简单地丢掉。系统需要持续维护它当前已经处理到哪里、已经生成了哪些 token、还允许生成多少 token,以及与这个请求相关的缓存状态。
因此,在 inference engine 里,
Request 更像一个长期存在的状态对象,而不是一次函数调用的参数。
一个非常简化的 request 可以想象成:
Request(
    prompt_token_ids=...,
    output_token_ids=...,
    sampling_params=...,
    status=...,
)
真实系统里还会维护更多状态,但这里最重要的不是具体字段,而是先建立一个认识:
一个 Request 会跨越很多轮 GPU forward,并在这些 forward 之间持续保存自己的状态。
这也是后面理解 Scheduler、KV cache management 和 request lifecycle 的基础。
16.1.2 在线推理面对的是动态 Workload
如果系统永远同时只有一个请求,那么事情其实没有那么复杂,一个一个处理就可以了。真正困难的是,在线服务里的 request 会不断到达,而且它们通常并不整齐。
例如某一时刻可能有三个请求:
Request A: prompt = 128 tokens, output = ?
Request B: prompt = 2048 tokens, output = ?
Request C: prompt = 32 tokens, output = ?
这里的 output=? 很重要。推理开始前,系统并不知道每个请求最后会生成多少 token。一个请求可能很快遇到 EOS,也可能一直生成到 max_new_tokens。与此同时,新的请求还可能继续到达,而已经进入系统的请求也会在不同时间结束。也就是说,某一时刻的活跃请求集合并不是固定的,而会随着时间不断变化。
更进一步说,动态的不只是当前有多少个 request,而是每一轮真正需要执行的 token workload。比如一个很长的 prompt 刚刚进入系统时,它可能需要处理大量 prompt token;等 prompt 处理完以后,这个 request 每一轮可能只需要继续生成一个 token。与此同时,另一个短请求又可能刚刚进入系统。
可以粗略想象成:
Iteration 1: A 正在处理长 prompt;
Iteration 2: A 继续处理 prompt,B 到达;
Iteration 3: A 开始生成,B 处理 prompt,C 到达;
Iteration 4: A 生成,B 生成,C 处理 prompt。
这里每一轮系统面对的工作都不同:有的 request 需要处理很多 token,有的只需要向前生成一步,还有的甚至还在等待执行机会。因此,LLM serving 的 workload 具有几个很明显的特点:
- 请求到达时间不同;
- Prompt 长度不同;
- 输出长度通常无法提前确定;
- 每个请求所处的执行阶段不同;
- 每一轮需要执行的 token 数量不同;
- 请求会不断进入,也会不断结束;
- 每个活跃请求都会占用一定的计算和显存资源。
这意味着,我们很难在一开始就构造一个固定 batch,然后一直运行到所有请求结束。真正的 inference engine 必须随着系统状态变化,不断重新决定下一轮应该执行哪些工作。
换句话说,LLM serving 处理的不是一个静态数据集,而是一个不断变化的 dynamic workload。后面我们会看到,prefill、decode、continuous batching 和 scheduling,本质上都在围绕这种动态 workload 展开。
16.1.3 LLM Inference 是 Stateful Serving
前面介绍 KV cache 时,我们已经知道,自回归推理会缓存历史 token 的 key 和 value,从而避免每生成一个 token 都重新计算完整前缀。这里不再重复 KV cache 的具体计算过程,而是从系统角度看它带来的另一个影响:
LLM inference 是有状态的。
一个正在运行的 request 不只是 CPU 上的一组 token ID,它通常还对应 GPU 上持续存在的 KV cache。
可以把一个活跃请求粗略理解成:它既有 CPU 侧的 token、sampling 参数和 request status,也有 GPU 侧持续存在的 KV cache state。其中前几项通常很小,而 KV cache 可能占据大量 GPU memory,并且会随着 sequence 继续生成而不断增长。
这会带来一个非常重要的区别。模型参数在推理过程中基本是静态的:模型加载到 GPU 后,权重不会因为某个 request 生成了一个新 token 就发生变化。但是 KV cache 是动态的。

因此,对于 inference engine 来说,GPU memory 不只是能不能装下模型的问题,还要考虑:
当前这些活跃 request 的动态状态能不能装下。
这也是为什么现代推理系统里,KV cache management 会成为一个独立而非常重要的问题。后面我们会单独讨论它如何分配、增长、复用和释放。
16.1.4 GPU 执行的是 Batch,而不是 Request
不过,虽然用户看到的是一个个独立的 request,但 GPU 最终执行的仍然是 tensor computation。也就是说,系统不能简单地把一个 Python 请求对象交给 GPU。真正执行之前,系统需要先决定哪些 request 在这一轮参与计算,再把它们组织成模型可以执行的 tensor 和 metadata。
这里需要区分两个视角:

Request 是用户和系统长期维护的逻辑对象,而 execution batch 是某一轮真正送进 GPU 的工作集合。两者并不是一一对应的。一个 request 不一定完整地进入一次 batch。例如一个很长的 prompt 可能只在这一轮处理其中一部分 token,一个正在生成的 request 这一轮可能只处理一个 token。反过来,一个 execution batch 也可能同时包含多个 request 的工作。
因此,这里的 batch 和训练时固定的 mini-batch 有明显区别。训练时,一个 batch 通常在一个 training step 开始之前就已经确定。而在线推理中,请求会随时加入和退出,因此 batch 也可能每一轮都发生变化:
Iteration 1:  A  B  C
Iteration 2:  A  B  C  D
Iteration 3:  A     C  D
Iteration 4:        C  D  E
这里 B 可能已经生成结束,因此从下一轮 batch 中消失;D 和 E 则是在服务运行过程中才到达的新请求。
所以,现代推理引擎真正需要解决的并不是怎样执行一个固定 batch,而是:
怎样把当前所有活跃 request,持续转换成一轮又一轮适合 GPU 执行的 workload。
这个转换过程正是 Scheduler 存在的原因。也会进一步引出后面的 continuous batching、token budget 和 chunked prefill 等技术。
16.1.5 Scheduler 决定这一轮跑什么
假设某一时刻系统里有很多正在等待或者正在执行的请求。GPU 的计算能力和显存都是有限的,不可能每一轮都把所有 request 一起送进去。于是,在每次执行 GPU forward 之前,系统都需要根据当前请求状态、可用资源和 scheduling policy 做一次选择。
负责这件事的组件通常称为 Scheduler。

从抽象上看,Scheduler 做的事情很简单:
根据当前 request 状态和系统资源,决定下一轮 GPU 要处理哪些工作。
注意,这里的“工作”不一定等于一个完整 request。
一个长 prompt 可能不会一次处理完;一个正在 decode 的 request 这一轮可能只需要继续生成一个 token;不同 request 也可能在同一轮里一起执行。因此,Scheduler 真正关心的通常是更细粒度的执行预算,例如当前还能处理多少 token、还能分配多少 KV cache,以及哪些 request 应该优先进入这一轮计算。
比如某一轮系统里可能存在:
Request A: 还有 800 个 prompt token 等待处理
Request B: 需要继续 decode 1 个 token
Request C: 需要继续 decode 1 个 token
Request D: 还在 waiting
如果这一轮 GPU 的执行预算有限,Scheduler 就必须决定:是优先处理更多 prompt token,还是保证正在 decode 的 request 继续向前推进,又或者在两者之间做某种折中。
这里暂时不讨论具体 scheduling policy,只需要先记住:Scheduler 位于 request queue 和 execution batch 之间。后面讨论 continuous batching、chunked prefill 以及更复杂的调度策略时,本质上都在继续回答同一个问题:
这一轮 GPU 到底应该跑什么?
16.1.6 Model Runner 把执行计划变成 GPU Forward
Scheduler 决定的是这一轮跑什么,但它通常不会直接完成模型计算。
例如,Scheduler 可能得到一个类似这样的执行计划:
Request A: Process some prompt tokens
Request B: Generate next token
Request C: Generate next token这些仍然是系统层面的对象和决策。而模型真正能够接受的却是 tensor,以及 attention、position、KV cache 等相关 metadata。因此,中间还需要完成一次从系统世界到模型执行世界的转换。
这个角色可以抽象成 Model Runner。

Model Runner 接收 scheduling result,根据这一轮真正要执行的 workload 准备模型输入,然后调用底层 model forward。不同 inference engine 对这一层的划分并不完全一样,但从抽象上看,它们解决的是同一个问题:
怎样把 Scheduler 的执行计划,转换成一次真正可以在 GPU 上运行的模型计算。
因此,可以把 Scheduler 和 Model Runner 的职责粗略区分为:
| 组件 | 职责 |
|---|---|
| Scheduler | 决定这一轮跑什么 |
| Model Runner | 把这一轮工作转换成模型输入,并真正跑起来 |
这个边界非常重要。Scheduler 主要操作 request、token budget、memory resource 这类系统对象,而 Model Runner 最终面对的是 tensor、attention metadata、KV cache metadata。后面阅读具体推理框架时,我们会经常看到类似的分层。
当然,Model Runner 得到 logits 以后,系统还需要完成 sampling、更新 request state、判断请求是否结束,并把仍然没有结束的请求重新交给后续 scheduling iteration。
于是,一次 inference engine 的执行不再是一条直线,而是一个循环。
16.1.7 Inference Engine 是一个不断运行的循环
把前面的组件放在一起,一个非常简化的 inference engine 可以写成:
while True:
    receive_requests()

    batch = scheduler.schedule()
    logits = model_runner.forward(batch)

    next_tokens = sample(logits)
    update_requests(next_tokens)

    finish_completed_requests()
    release_unused_resources()
这段代码不是某个真实框架的实现,而只是描述 inference engine 最核心的控制流。
它可以画成:

这里最值得注意的是从 Update Request State 回到 Scheduler 的那条路径。一个 request 在一次 GPU forward 以后通常并没有结束。它只是向前推进了一小步,然后带着新的 token、新的 KV cache 状态和新的执行位置,再次进入下一轮调度。
所以,现代 LLM inference engine 的基本运行方式就是一个循环。也就是说,Inference Engine 的基本执行单位不是一个完整 request,而是一轮又一轮的 scheduling iteration。
这个视角非常重要。后面无论我们讨论 continuous batching、KV cache management,还是进一步阅读 vLLM 和 SGLang 的 Scheduler,都可以回到这个循环里理解:它们只是在回答不同阶段应该如何更高效地组织这套循环。
16.1.8 本章小结
这一节没有讨论模型如何计算 next token,而是把视角从单个模型调用切换到了整个 inference engine。
在真实的在线推理中,一个 request 往往会跨越很多轮 GPU forward,并在整个生命周期里持续保存自己的 token、sampling 参数和 KV cache 等状态。因此,LLM inference 并不是简单的 stateless function call,而是一种需要持续维护 request state 的 stateful serving。
与此同时,在线请求会不断到达和结束,prompt 长度和生成长度也各不相同,所以系统面对的是一个 dynamic workload。用户看到的是一个个 request,但 GPU 真正执行的是每一轮重新组织出来的 batch。Scheduler 负责从当前 request 和资源状态中决定这一轮跑什么,Model Runner 再把这个执行计划转换成 tensor 和 metadata,真正送进 GPU 完成 forward。
因此,可以把现代 LLM inference engine 最核心的工作概括成:
Model 负责计算,Inference Engine 负责组织计算。
从系统角度看,后面很多看起来独立的技术,其实都可以放回这条主线里理解:
- Request 的 workload 为什么会发生变化?这会引出 prefill 与 decode;
- Request 为什么会长期占用 GPU memory?这会引出 KV cache;
- 多个 request 怎样在不同 iteration 中一起运行?这会引出 continuous batching;
- 每一轮到底选择哪些工作?这会引出 scheduling;
- 动态增长的 KV state 怎样分配和回收?这会引出 KV cache management;
- Scheduling 结果怎样最终变成一次 GPU forward?这会引出 Model Runner。
其中最先需要理解的是 LLM workload 本身。一次 request 从进入系统到完成生成,并不是始终具有相同的计算特征,而是天然分成两个性质差异很大的阶段:prefill 和 decode。下一节,我们就从这两个阶段开始。